
ddddocr rust 版本。
ocr_api_server rust 版本。
二进制版本,验证码识别,不依赖 opencv 库,跨平台运行。
a simple OCR API server, very easy to deploy。


一个容易使用的通用验证码识别 rust 库
·
报告Bug
·
提出新特性
| 系统 | CPU | GPU | 备注 |
|---|---|---|---|
| Windows 64位 | √ | ? | 部分版本 Windows 需要安装 vc 运行库 |
| Windows 32位 | √ | ? | 不支持静态链接,部分版本 Windows 需要安装 vc 运行库 |
| Linux 64 / ARM64 | √ | ? | 可能需要升级 glibc 版本, 升级 glibc 版本 |
| Linux 64 / MUSL | √ | ? | 不需要 glibc,静态链接 |
| Linux 32 | × | ? | |
| Macos X64 | √ | ? | M1/M2/M3 ... 芯片参考 #67 |
lib.rs 实现了 ddddocr。
main.rs 实现了 ocr_api_server。
model 目录是模型与字符集。
依赖本库 ddddocr = {git = "https://github.com/86maid/ddddocr.git", branch = "master"}
开启 cuda 特性 ddddocr = { git = "https://github.com/86maid/ddddocr.git", branch = "master", features = ["cuda"] }
支持静态和动态链接,默认使用静态链接,构建时将会自动下载链接库,请设置好代理,cuda 特性不支持静态链接(会自己下载动态链接库)。
如有更多问题,请跳转至疑难杂症部分。
如果你不想从源代码构建,这里有编译好的二进制版本。
本仓库的 GitHub Actions 只负责构建并发布 Docker 镜像(见 Docker 部署);如需二进制,请本地 cargo build 或使用上游 86maid/ddddocr releases。
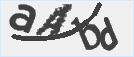
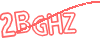
主要用于识别单行文字,即文字部分占据图片的主体部分,例如常见的英数验证码等,本项目可以对中文、英文(随机大小写or通过设置结果范围圈定大小写)、数字以及部分特殊字符。
let image = std::fs::read("target.png").unwrap();
let mut ocr = ddddocr::ddddocr_classification().unwrap();
let res = ocr.classification(image).unwrap();
println!("{:?}", res);let image = std::fs::read("target.png").unwrap();
let mut ocr = ddddocr::ddddocr_classification_old().unwrap();
let res = ocr.classification(image).unwrap();
println!("{:?}", res);classification_with_png_fix(image, true);
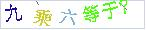
支持以下预设颜色:red(红色)、blue(蓝色)、green(绿色)、yellow(黄色)、orange(橙色)、purple(紫色)、cyan(青色)、black(黑色)、white(白色)、gray(灰色)。
let ddddocr = ddddocr_classification().unwrap();

// 只保留绿色
println!(
    "{}",
    ddddocr
        .classification_with_filter(include_bytes!("../image/4.png"), "green")
        .unwrap()
);

// 只保留红色和绿色
println!(
    "{}",
    ddddocr
        .classification_with_filter(include_bytes!("../image/4.png"), ["red", "green"])
        .unwrap()
);

// HSV 范围,每个元素是一个 (min_hsv, max_hsv) 的元组。
println!(
    "{}",
    ddddocr
        .classification_with_filter(
            include_bytes!("../image/4.png"),
            [((40, 50, 50), (80, 255, 255))]
        )
        .unwrap()
);
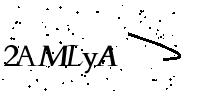


let image = std::fs::read("target.png").unwrap();
let mut det = ddddocr::ddddocr_detection().unwrap();
let res = det.detection(image).unwrap();
println!("{:?}", res);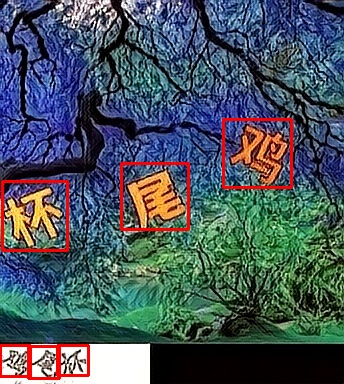
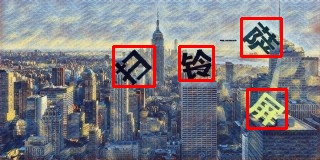
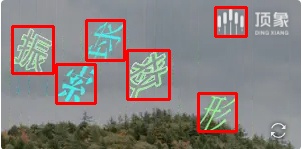
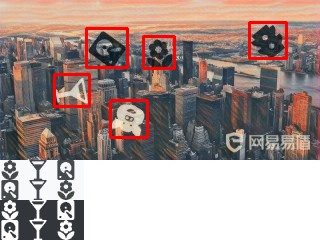
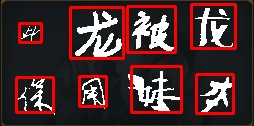
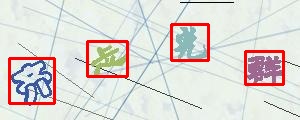
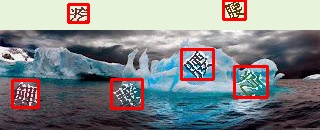
以上只是目前我能找到的点选验证码图片,做了一个简单的测试。
算法非深度神经网络实现。
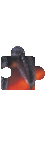
小滑块为单独的png图片,背景是透明图,如下图:
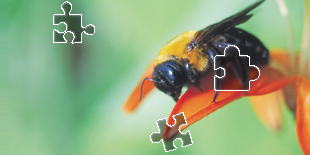
然后背景为带小滑块坑位的,如下图:
let target_bytes = std::fs::read("target.png").unwrap();
let background_bytes = std::fs::read("background.png").unwrap();
let res = ddddocr::slide_match(target_bytes, background_bytes).unwrap();
println!("{:?}", res);
如果小图无过多背景部分,则可以使用 simple_slide_match,通常为 jpg 或者 bmp 格式的图片
let target_bytes = std::fs::read("target.png").unwrap();
let background_bytes = std::fs::read("background.png").unwrap();
let res = ddddocr::simple_slide_match(target_bytes, background_bytes).unwrap();
println!("{:?}", res);一张图为带坑位的原图,如下图:
一张图为原图,如下图:
let target_bytes = std::fs::read("target.png").unwrap();
let background_bytes = std::fs::read("background.png").unwrap();
let res = ddddocr::slide_comparison(target_bytes, background_bytes).unwrap();
println!("{:?}", res);为了提供更灵活的 ocr 结果控制与范围限定,项目支持对ocr结果进行范围限定。
可以通过在调用 classification_probability 返回全字符表的概率。
当然也可以通过 set_ranges 设置输出字符范围来限定返回的结果。
| 参数值 | 意义 |
|---|---|
| 0 | 纯整数 0-9 |
| 1 | 纯小写字母 a-z |
| 2 | 纯大写字母 A-Z |
| 3 | 小写字母 a-z + 大写字母 A-Z |
| 4 | 小写字母 a-z + 整数 0-9 |
| 5 | 大写字母 A-Z + 整数 0-9 |
| 6 | 小写字母 a-z + 大写字母A-Z + 整数0-9 |
| 7 | 默认字符库 - 小写字母a-z - 大写字母A-Z - 整数0-9 |
如果值为 string 类型,请传入一段不包含空格的文本,其中的每个字符均为一个待选词,例如:"0123456789+-x/="
let image = std::fs::read("image.png").unwrap();
let mut ocr = ddddocr::ddddocr_classification().unwrap();

// 数字 3 对应枚举 CharsetRange::LowercaseUppercase,不用写枚举
// ocr.set_ranges(3);

// 设置全局字符集
ocr.set_ranges("0123456789+-x/=");

// 或者,单次识别的字符集
// ocr.classification_probability_with_ranges(image, "0123456789+-x/=");

let result = ocr.classification_probability(image).unwrap();

println!("识别结果: {}", result.get_text());
println!("识别可信度: {}", result.get_confidence());

// 哦呀,看来数据有点儿太多了,小心卡死哦!
println!("概率: {}", result.json());验证码字数已知时,可以指定期望长度。识别结果超过该长度时,会依片段峰值概率由低到高丢弃多余片段;未指定时行为不变。
let image = std::fs::read("image.png").unwrap();
let ocr = ddddocr::ddddocr_classification().unwrap();

// 直接指定长度
let text = ocr.classification_with_length(&image, 5).unwrap();

// 或者先取概率,再按长度解码
let mut result = ocr.classification_probability(&image).unwrap();
println!("识别结果: {}", result.get_text_with_length(5));
REST 的 /ocr 同样支持选填字段 length:
curl -X POST "http://127.0.0.1:8000/ocr" \
     -H "Content-Type: application/json" \
-d '{"image": "base64 image", "length": 5}'支持导入 dddd_trainer 训练后的自定义模型。
use ddddocr::*;

let mut ocr = Ddddocr::with_model_charset(
    "myproject_0.984375_139_13000_2022-02-26-15-34-13.onnx",
    "charsets.json",
)
.unwrap();
let image_bytes = std::fs::read("888e28774f815b01e871d474e5c84ff2.jpg").unwrap();
let res = ocr.classification(&image_bytes).unwrap();
println!("{:?}", res);Usage: ddddocr.exe [OPTIONS]
Options:
--address <ADDRESS>
监听地址。 [default: 0.0.0.0:8000]
--mcp
mcp 协议支持,与 only_mcp 互斥。
--only-mcp
仅开启 mcp 协议,不开启普通路由,与 mcp 互斥。
--ocr
开启内容识别,与 old 互斥。
--old
开启旧版模型内容识别,与 ocr 互斥。
--det
开启目标检测。
--slide
开启滑块和坑位识别。
--ocr-charset-range <OCR_CHARSET_RANGE>
全局默认字符集,用于概率识别, 如果 API 未提供字符集,则使用此参数, 当值为 0~7 时,表示选择内置字符集, 其他值表示自定义字符集,例如 "0123456789+-x/=", 如果未设置,则使用完整字符集,不做限制。
--ocr-path <OCR_PATH>
内容识别模型以及字符集路径, 如果你开启了 features 的 inline-model 选项(默认开启),则不用管这个选项,除非你想使用自定义模型, 模型 model/common.onnx 和字符集 model/common.json 要同名。 [default: model/common.onnx]
--det-path <DET_PATH>
目标检测模型路径, 如果你开启了 features 的 inline-model 选项(默认开启),则不用管这个选项,除非你想使用自定义模型。 [default: model/common_det.onnx]
--acme <ACME>
输入你的域名,自动获取 SSL 证书, 即 https 的支持。
-h, --help
Print help# 启动所有功能
ddddocr.exe --address 0.0.0.0:8000 --ocr --det --slide --mcp
# 查看所有选项
ddddocr.exe --help| 端点 | 方法 | 说明 |
|---|---|---|
/ |
GET | 静态首页 |
/ocr |
POST | 执行OCR识别 |
/det |
POST | 执行目标检测 |
/slide_match |
POST | 滑块匹配算法 |
/slide_comparison |
POST | 滑块比较算法 |
/status |
GET | 获取当前服务状态 |
/docs |
GET | Swagger UI 文档 |
/docs.json |
GET | OpenAPI JSON 描述 |
/mcp |
POST | MCP 协议(JSON-RPC) |
启动服务后,Swagger UI 位于 http://127.0.0.1:8000/docs,可以直接在浏览器里用 Try it out 发起请求;OpenAPI 描述位于 http://127.0.0.1:8000/docs.json,可以导入 Postman / Apifox,或用于生成 client SDK。
请求要点:
- 请求头使用
Content-Type: application/json。 - 所有图片字段(
image、target_image、background_image)都是原始 base64 字符串,不要加data:image/png;base64,前缀。 - 统一响应格式为
{"code":200,"msg":"success","data":{...}},错误也走同一格式,例如请求体缺少必填字段时返回{"code":400,"msg":"...missing field ...","data":null}。 - 文档只列出启动时已开启功能对应的路由:例如默认以
--ocr --det --slide --mcp启动时,OpenAPI 中包含/ocr、/det、/slide_match、/slide_comparison、/status;若以--only-mcp启动,服务只有/status与/mcp两个路由,OpenAPI 中只会看到/status(/mcp是 JSON-RPC 端点,不在 OpenAPI 描述内)。未开启的功能路由会返回 404。 - 常用快速验证:
curl http://127.0.0.1:8000/status。
启动服务后,访问 http://127.0.0.1:8000/ 可以看到项目首页,包含基础介绍和 API 使用示例。首页为静态 HTML 文件,位于 static/index.html,使用 TailwindCSS v4、Remix Icon 和 Google Fonts(均通过 CDN 引入)。
首页源码在 webui/(Rspack v2 + Vue 3),建置产物输出到 static/。建置方式:
cd webui && yarn install && yarn build首页含在线 OCR 互动区:可以拖放或点击上传验证码图片,也可以直接在页面上粘贴(Ctrl+V)图片,页面会即时调用 POST /ocr 并显示识别结果。
static/ 是建置产物,不要手动修改;要改内容请修改 webui/src/ 后再重新建置。
静态资源路由:/assets/* 由服务器直接提供(Salvo StaticDir 以 static/ 为根目录),与首页 static/index.html(StaticFile)配合。使用 Docker Compose 时,docker-compose.yml 会把仓库的 static/ 以只读方式挂载到容器内的 /static(runtime 镜像的工作目录是 /),因此首页与 /assets/* 都能正常访问;若自行部署镜像而缺少该挂载,首页 / 会返回 404。
--> 200 GET /status

  curl -X GET "http://127.0.0.1:8000/status"

  {"code":200,"msg":"success","data":{"service_status":"running","enabled_features":["ocr","det","slide"]}}

--> 200 POST /ocr

  curl -X POST "http://127.0.0.1:8000/ocr"
       -H "Content-Type: application/json"
       -d '{"image": "base64 image"}'

  {"code":200,"msg":"success","data":{"text":"九乘六等于?","probability":null}}

--> 200 POST /det

  curl -X POST "http://127.0.0.1:8000/det"
       -H "Content-Type: application/json"
       -d '{"image": "base64 image"}'

  {"code":200,"msg":"success","data":{"bboxes":[[80,3,98,21],[56,6,76,25],[31,7,51,26],[2,2,21,22],[100,0,127,18]]}}

--> 200 POST /slide_match

  curl -X POST "http://127.0.0.1:8000/slide_match"
       -H "Content-Type: application/json"
       -d '{"target_image": "base64 image", "background_image": "base64 image", "simple_target": true}'

  {"code":200,"msg":"success","data":{"target":[215,45,261,91],"target_x":0,"target_y":45}}

--> 200 POST /slide_comparison

  curl -X POST "http://127.0.0.1:8000/slide_comparison"
       -H "Content-Type: application/json"
       -d '{"target_image": "base64 image", "background_image": "base64 image"}'

{"code":200,"msg":"success","data":{"x":144,"y":76}}本项目支持 MCP(Model Context Protocol)协议,使 AI Agent 能够直接调用 ddddocr 服务。
版本:2025-11-25
端点:POST /mcp
方法:initialize tools/list tools/call
{
    "jsonrpc": "2.0",
    "id": 0,
    "method": "tools/call",
    "params": {
        "name": "ocr",
        "arguments": {"image": "image_b64", "color_filter": "green"},
    },
}{
"jsonrpc": "2.0",
"id": 0,
"result": {
"content": [
{
"type": "text",
"text": "{\"probability\":null,\"text\":\"等于?\"}"
}
],
"isError": false
}
}官方提供了可直接运行的 linux/amd64 镜像 mmhk/ddddocr。镜像内是 musl 静态链接的二进制,模型已内嵌,运行时不依赖 model/ 目录。
docker pull mmhk/ddddocr:latest

docker run -d --name ddddocr -p 8000:8000 mmhk/ddddocr:latest
启动后验证服务是否正常:
curl http://127.0.0.1:8000/status仓库根目录已提供 docker-compose.yml,直接使用即可:
docker compose up -d        # 后台启动
docker compose ps           # 查看状态
curl http://127.0.0.1:8000/status   # 快速探活
docker compose logs -f      # 查看日志
docker compose down         # 停止并移除容器
升级到最新镜像:
docker compose pull && docker compose up -dcompose 文件要点:
image: mmhk/ddddocr:latest:直接使用官方镜像,无需本地构建。platform: linux/amd64:官方镜像只发布该架构;Apple Silicon 会走模拟。restart: unless-stopped:异常退出或重启宿主后自动拉起。ports: 8000:8000:把容器内监听端口映射到宿主机。volumes: ./static:/static:ro:以只读方式挂载首页静态文件。runtime 镜像工作目录是/,所以挂到/static;缺少该挂载时首页/会 404。RUST_LOG: info:日志级别,对应 tracing 的RUST_LOG。command可覆盖镜像默认的--ocr --det --slide --mcp,例如只保留 MCP 时改为["--only-mcp"]。
精简后的片段:
services:
  ddddocr:
    image: mmhk/ddddocr:latest
    container_name: ddddocr
    platform: linux/amd64
    restart: unless-stopped
    ports:
      - "8000:8000"
    volumes:
      - ./static:/static:ro
    environment:
      RUST_LOG: info
# command: ["--only-mcp"]想在容器内开发时,使用根目录的 docker-compose.dev.yml(与上面的执行期服务互不相干,不会占用 8000 埠):
docker compose -f docker-compose.dev.yml up -d --build   # 构建并启动 dev 容器
docker exec -it ddddocr-dev bash                          # 进入容器
# 容器内:cd /app && cargo check / cargo build --release
docker compose -f docker-compose.dev.yml down # 停止并移除target/、cargo registry 与 ort 下载缓存都放在 named volume,而非 Windows 绑定挂载,因此重建容器后 cargo check 仍可秒级完成,不需要重新编译依赖。
镜像默认以 --ocr --det --slide --mcp 启动,即同时开启内容识别、目标检测、滑块匹配与 MCP 协议。
传入的参数会覆盖默认 CMD。例如只开启内容识别、目标检测和滑块匹配:
docker run --rm -p 8000:8000 mmhk/ddddocr:latest --ocr --det --slide只开启 MCP 协议(此时仅注册 /status 与 /mcp 路由):
docker run --rm -p 8000:8000 mmhk/ddddocr:latest --only-mcp其他参数(--address、--ocr-charset-range、--acme 等)与本地运行完全一致,可参考运行方式。
- 镜像只提供
linux/amd64。Apple Silicon(M1/M2/M3 等)会以模拟方式运行,速度较慢。 - 标签规则:
latest指向最新发布版本,同时提供版本号标签。例如发布v1.2.3后,可以使用mmhk/ddddocr:1.2.3和mmhk/ddddocr:1.2。 - 镜像由 GitHub Actions 在推送
v*标签时自动构建并发布到 Docker Hub(linux/amd64,标签为latest与版本号)。工作流没有手动触发入口,需要发布时请推送新的v*标签。
注意:仓库根目录的
Dockerfile只是 musl 编译环境(rust:1.95.0-alpine,用完即弃),不是可直接运行的服务镜像。可直接运行的服务镜像定义在Dockerfile.runtime。
本 fork 的 GitHub Actions 只发布 Docker 镜像(见 Docker 部署),不再产出各平台二进制;如需二进制,请本地 cargo build 或使用上游 86maid/ddddocr releases。
识别结果与旧版本不同?官方行模型已改为统一的 CTC 解码:相邻相同字符只在连续时合并,空白会中断重复,因此同一张图里跨空白的重复字符现在会被保留(例如 355fx 不再被压成 35fx)。只有带 length 时才会按峰值概率丢弃多余片段。已知差异:45g46 / g2n8g 这类左侧带残缺笔画的图片在未指定 length 时会多出一个字符,指定正确字数即可消除。
关于使用 cuda 的问题。
cuda 和 cuDNN 都需要安装好。
CUDA 12 构建需要 cuDNN 9.x。
CUDA 11 构建需要 cuDNN 8.x。
不确定 cuda 10 是否有效。
默认使用静态链接,构建时将会自动下载链接库,请设置好代理,cuda 特性不支持静态链接(会自己下载动态链接库)。
如果要指定静态链接库的路径,可以设置环境变量 ORT_LIB_LOCATION,设置后将不会自动下载链接库。
例如,库路径为 onnxruntime\build\Windows\Release\Release\onnxruntime.lib,则 ORT_LIB_LOCATION 设置为 onnxruntime\build\Windows\Release。
默认开启 download-binaries 特性,自动下载链接库。
下载不了大部分是网络问题,开启代理后,记得重启 vscode,重启终端,以便代理能够使用 https_proxy 环境变量。
自动下载的链接库存放在 C:\Users\<用户名>\AppData\ort.pyke.io。
开启动态链接特性 ddddocr = { git = "https://github.com/86maid/ddddocr.git", branch = "master", features = ["load-dynamic"] }
开启 load-dynamic 特性后,可以使用 Ddddocr::set_onnxruntime_path 指定 onnxruntime 动态链接库的路径。
开启 load-dynamic 特性后,构建时将不会自动下载 onnxruntime 链接库。
请手动下载 onnxruntime 链接库,并将其放置在程序运行目录下(或系统 API 目录),这样无需再次调用 Ddddocr::set_onnxruntime_path。
windows 静态链接失败,请安装 vs2022。
linux musl 要用 docker 编译。
linux x86-64 静态链接失败,请安装 gcc11 和 g++11,ubuntu ≥ 20.04。
linux arm64 静态链接失败,需要 glibc ≥ 2.35 (Ubuntu ≥ 22.04)。
macOS 静态链接失败,需要 macOS ≥ 10.15。
cuda 在执行 cargo test 的时候可能会 painc (exit code: 0xc000007b),这是因为自动生成的动态链接库是在 target/debug 目录下,需要手动复制到 target/debug/deps 目录下(cuda 目前不支持静态链接)。
动态链接需要 1.18.x 版本的 onnxruntime。
更多疑难杂症,请跳转至 ort.pyke.io。