
把 PDF 文档变成可检索的知识,让 AI 的每一句回答都能追溯到原文的页码与位置。


| 仓库 | 说明 | 技术栈 |
|---|---|---|
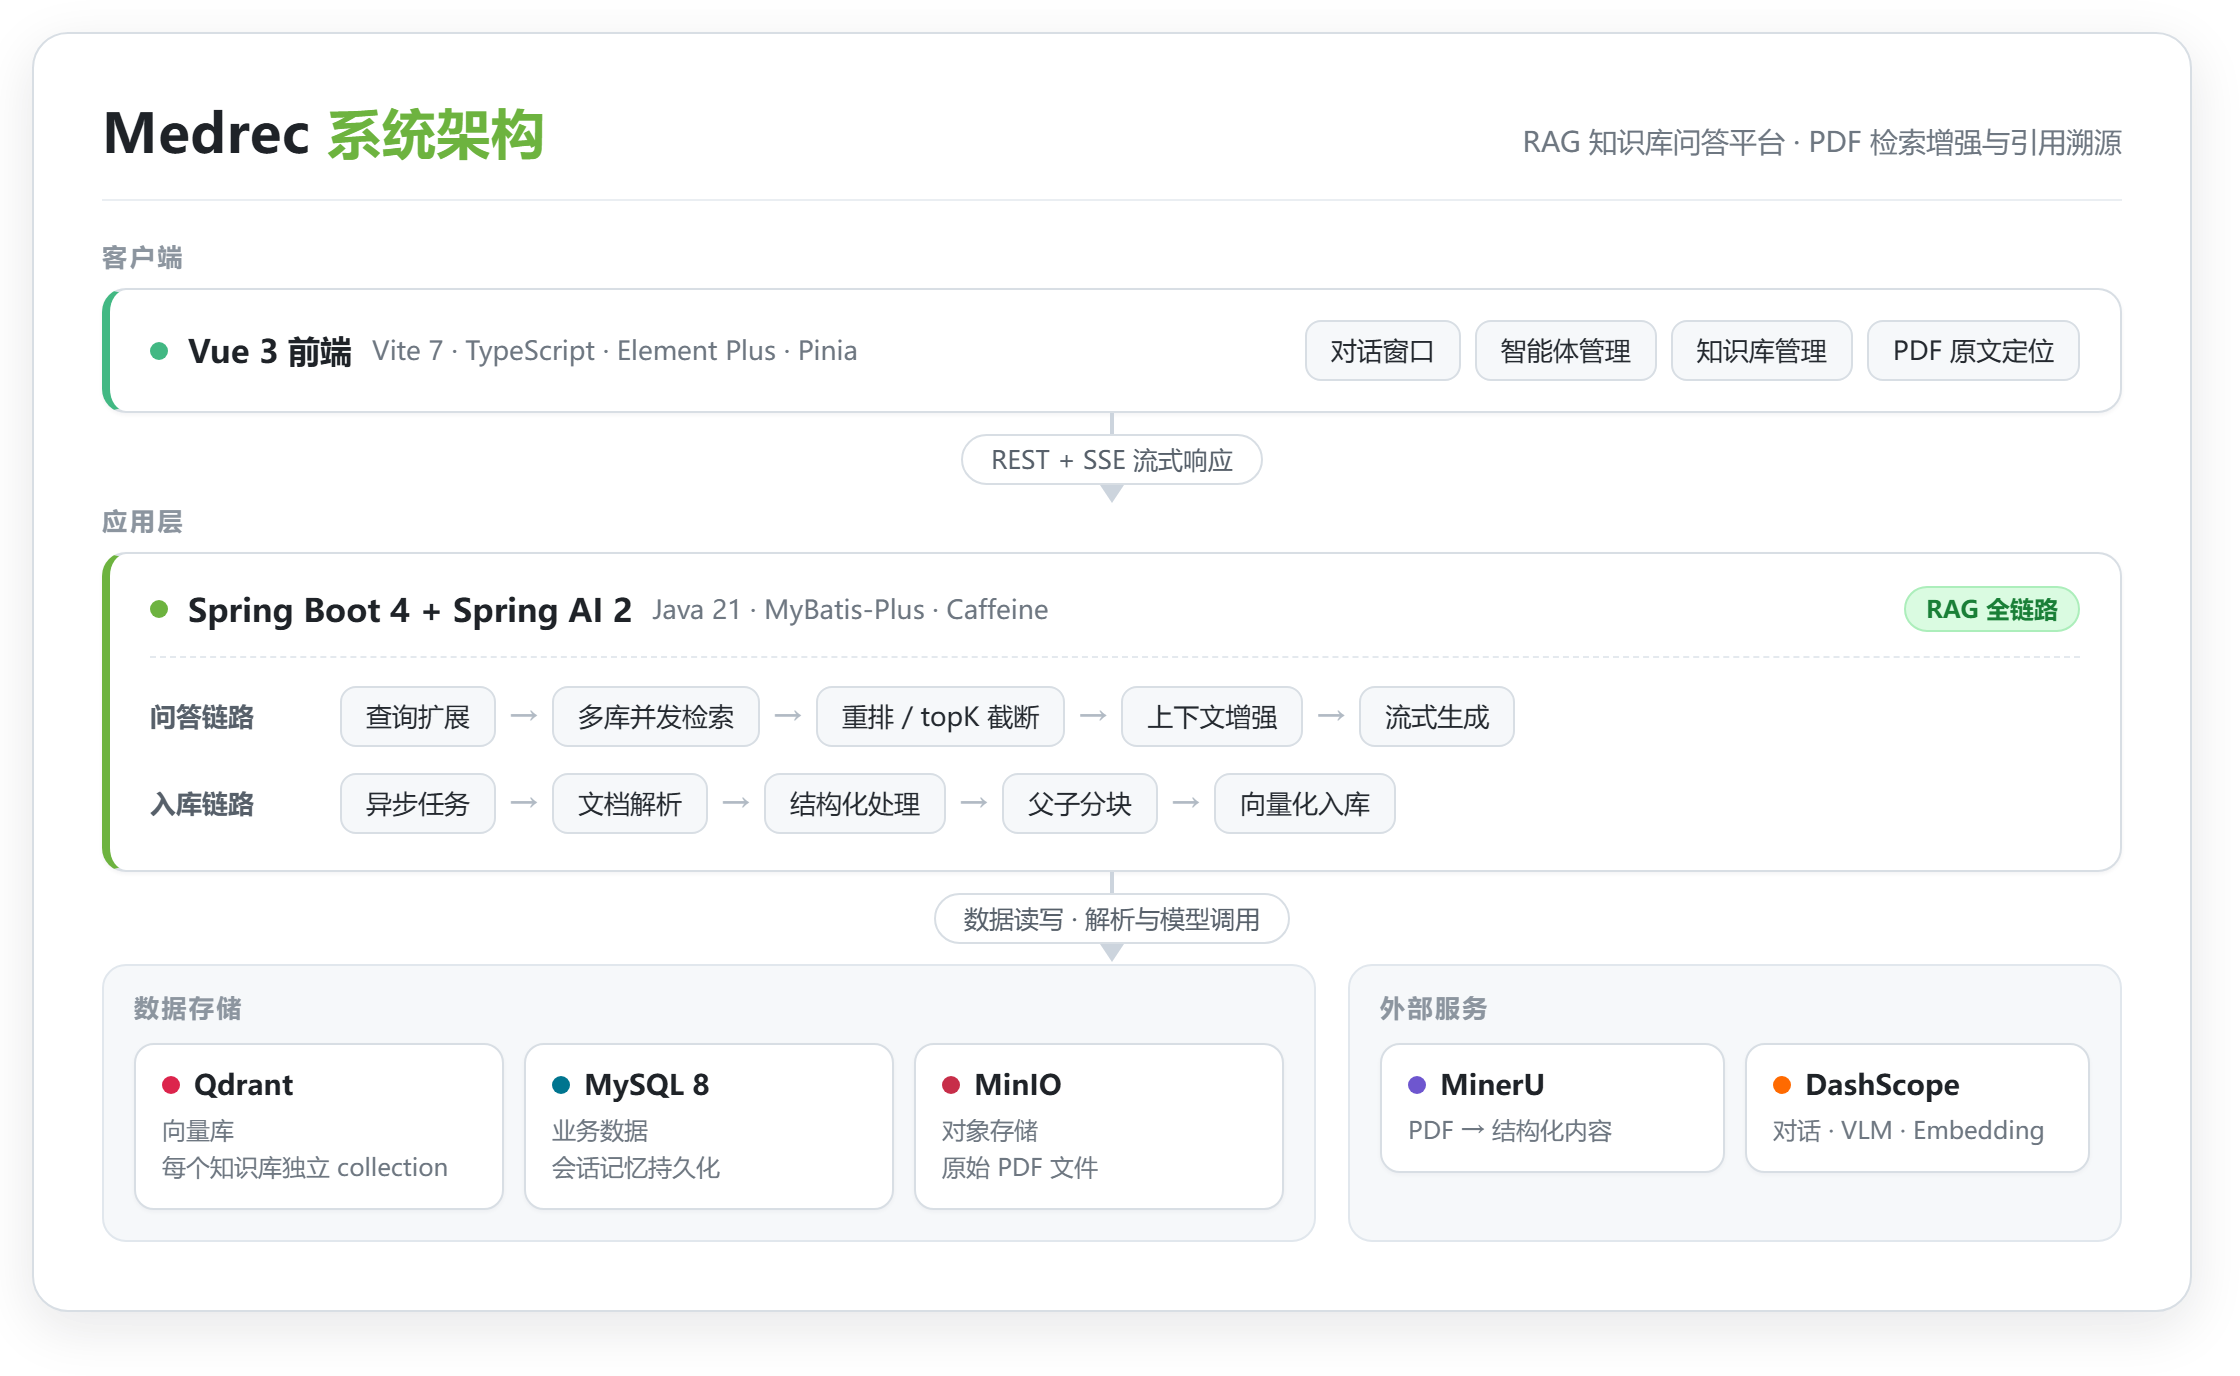
| medrec | 后端服务:RAG 全链路、文档解析入库、多知识库检索、流式对话、引用溯源 | Spring Boot 4 · Spring AI 2 · Qdrant · MySQL · MinIO |
| front | 前端应用:智能体与知识库管理、流式对话、PDF 原文定位 | Vue 3 · Vite 7 · TypeScript · Element Plus · Pinia |
- 文档入库:MinerU 将 PDF 解析为结构化内容 → 表格 / 列表 / 图片(多模态描述)分别处理 → 父子分块 → 向量化入库,全流程异步任务化并带失败补偿
- 检索增强:查询扩展消解指代 → 多知识库并发检索 → 相似度重排与 topK 截断 → 上下文拼装
- 引用溯源:回答逐句标注
<ID>文档ID</ID>,前端点击即可跳转 PDF 指定页并高亮 bbox 区域 - AI 智能体:可配置提示词、温度、
topK、相似度阈值与记忆轮数,并挂载任意多个知识库
完整的环境要求、配置与启动说明见后端仓库 README。最短路径:
git clone git@github.com:medrec-sys/medrec.git && cd medrec
docker compose -f md-com.yml up -d                     # 启动 MySQL / MinIO / Qdrant
mysql -h127.0.0.1 -P9006 -uroot -p < data/table.sql     # 初始化数据库
mvn spring-boot:run                                     # 启动后端
git clone git@github.com:medrec-sys/front.git && cd front
npm ci && npm run dev # 启动前端